Nouvelles optimisations sur le scrolling multi-directionnel
Encore une nouvelle routine ?
La routine proposée pour le double buffer me semblait assez gourmande et le source proposé manquait de flexibilité. J'ai donc réécrit plusieurs parties et utilisé un autre jeu de tuiles, une autre taille de map. Notre nouveau moteur sera plus flexible et aussi plus rapide, tout en consommant peu de mémoire supplémentaire.Tout d'abord, nous définirons notre moteur de scroll avec différentes constantes :
ENGINE_MAP_WIDTH equ 128
|
Ces constantes ont pour but de rendre certaines parties du source plus lisibles.
Comment est-ce possible d'accélérer encore ?
Nous avions déjà accéléré pas mal de choses tant sur l'affichage en ligne que celui en colonne. J'évoquais la possibilité d'avoir un deuxième jeu de données de nos tuiles avec les données en colonnes.C'est la technique sans compilation la plus efficace mais il y a un entre-deux qui s'en approche en vitesse, tout en limitant l'occupation mémoire, c'est la découpe en tranches!
Le principe est d'éclater les lignes des tiles en les répartissant dans des blocs de 256 octets. Le premier bloc regroupe les lignes 0 de plusieurs tuiles, le deuxième bloc les lignes 1, etc.
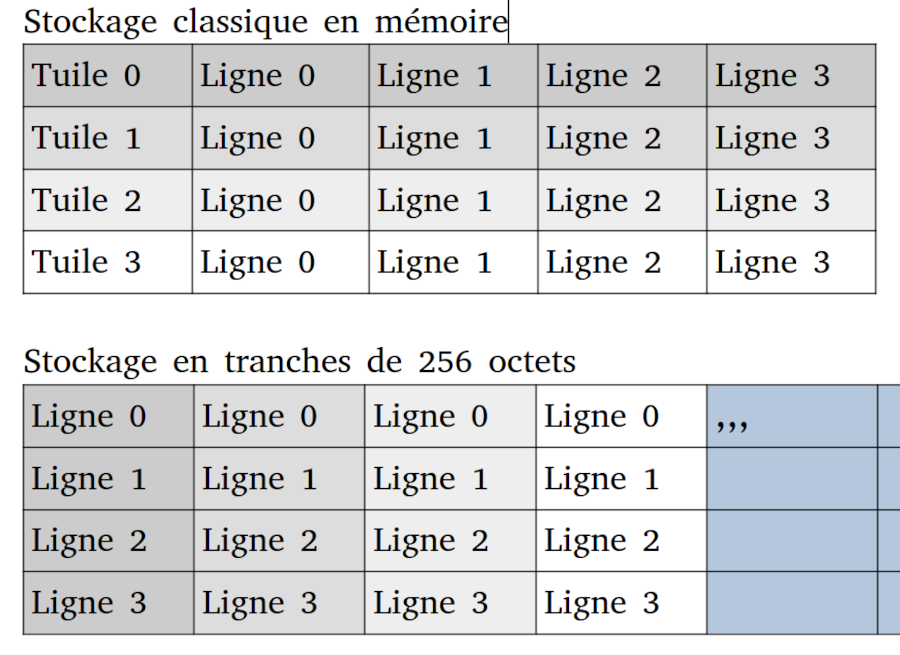
Si on dispose de beaucoup de tuiles, il faut constituer plusieurs groupes.
Concrètement, au niveau des calculs, l'affichage de lignes horizontales est toujours aussi rapide, on lit les données en linéaire. L'affichage vertical dispose d'un boost immédiat sur le calcul du pixel du dessous, résumé à un simple incrément du poids fort de l'adresse. La seule routine qui perd légèrement en vitesse est celle qui dessine l'écran de départ. On s'en accomodera fort bien.
Chargement des données
Je vous invite à télécharger la dernière version de [RASM] qui introduit le support de l'import en tranches. Un tel import nécessite d'aligner les données sur 256 octets.L'option SLICE a besoin de connaitre les dimensions de vos tuiles, ici 8 octets de large sur 32 lignes de haut
align 256 : tuiles incbin 'tuiles.bin',SLICE,8,32
|
Vous pouvez réaliser cet import avec des boucles REPEAT, des ORG, des calculs mais autant laisser faire le maestro.
Indexation des données
Exemple de génération de l'indexation des tuiles (pour retrouver leur groupe surtout) pour un maximum de 128 tuiles
align 256 : tuiles incbin 'grouik.bin',SLICE,ENGINE_TILE_WIDTH,ENGINE_TILE_HEIGHT
|
Voici le code pour la lecture de l'adresse d'une tuile A pour une table linéaire de 128 tuiles maximum
ld h,hi(tuiles_index) : add a : ld l,a : ld a,(hl) : inc l : ld h,(hl) : ld l,a
|
Si votre moteur est capable d'exporter les tuiles en index pré-multiplié, on peut enlever la multiplication par 2 de A, on gagne 1 nop
ld h,hi(tuiles_index) : ld l,a : ld a,(hl) : inc l : ld h,(hl) : ld l,a
|
On peut appliquer le principe du poids fort pour monter à 256 tuiles (maximum pratique de nombreux projets)
align 256 : tuiles incbin 'grouik.bin',SLICE,ENGINE_TILE_WIDTH,ENGINE_TILE_HEIGHT
|
Et voici le code pour la lecture de l'adresse d'une tuile A dans la table à 256 entrées maximum.
ld h,hi(tuiles_index) : ld l,a : ld a,(hl) : inc h : ld h,(hl) : ld l,a
|
L'autre intérêt de ce type d'indexation est que le code de calcul et la génération de la table restent identiques en cas de changement de taille de tuile.
Macro utiles
Légère évolution du côté de nos macros qui servent partout, les voici :Le calcul de l'adresse d'une tuile à partir de la tile courante (pointée par HL', résultat dans HL)
Pour increment == 0 : Pas de déplacement dans la tileMap
Pour increment == 1 : incrémentation dans la tileMap
Pour toute autre valeur : ajout 16 bits à tileMap
MACRO calculeAdresseTuile increment
|
La macro dédiée à une tuile ainsi qu'une ligne différente de zéro
MACRO calculeAdresseTuileLigne increment
|
La macro dédiée à une tuile ainsi qu'une colonne différente de zéro
MACRO calculeAdresseTuileColonne increment
|
Enfin la macro dédiée à une tuile, en spécifiant la colonne et la ligne!
MACRO calculeAdresseTuileLigneColonne increment
|
On se retrouve pour la suite des modifications du moteur dans la [ page suivante ]